AI 分類不確定時怎麼辦?設計轉人工條件與錯誤回看方式
從標籤定義、人工標注到轉人工門檻與案例重測,建立可追溯的 AI 分類例外處理流程。
AI 分類最容易出錯的地方,往往不是模型完全看不懂,而是訊息同時包含兩個意圖、關鍵資料缺漏,或新情境不在既有標籤裡。若系統被要求每次都選一類,模糊內容就會被硬塞進看似合理的答案,後續流程卻可能走錯。可行做法是先定義標籤,再把不能安全判定的情況交給人,並讓每次覆核都留下可重測的紀錄。這不是追求把每件事都自動化,而是把判定邊界、責任交接和錯誤回顧設成一條閉環;人工修正也要回到樣本與規則,才能避免相同例外一再出現。以下用「收到的工作訊息如何分類與派送」作為假設情境,標籤與門檻須依自己的資料調整。
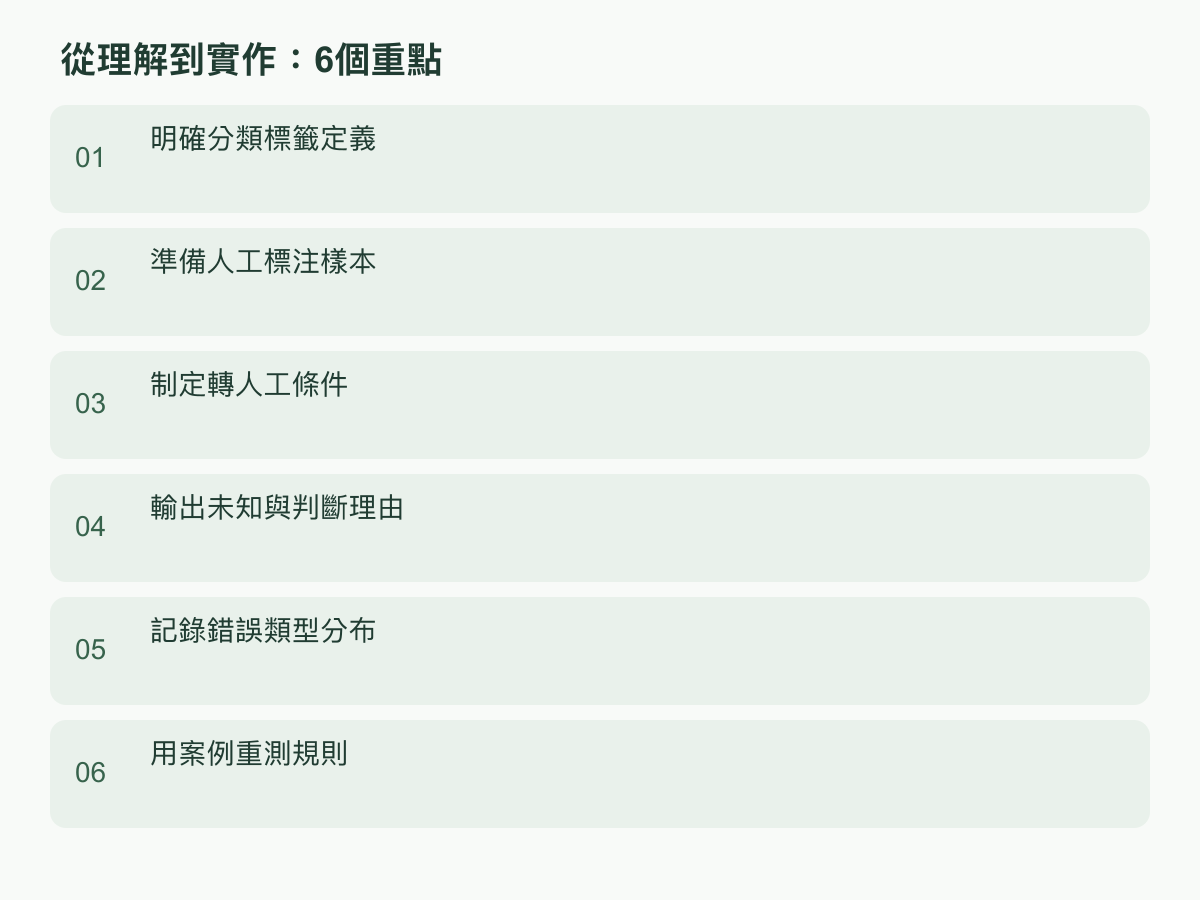
明確分類標籤定義
先把分類的用途說清楚:它要決定下一步由誰處理、要補什麼資料,還是只供統計;用途不同,標籤顆粒度也不同。以假設的營運信箱為例,可先列「訂單狀態」「付款或退款」「商品資訊」「帳號權限」「資訊不足/其他」。每個標籤都要寫納入條件、排除條件、最低必要線索與一個邊界例。「退款」可要求訊息明確提到退回款項;「我不想要了」未說明是否已下單,就先標資訊不足並補問,不能自行猜成退款。 同一則訊息可能有多個問題,要先決定採單一主標籤、多標籤,還是拆成多筆。若後續流程一次只能派一組,主標籤依「先處理哪項才能繼續」選定,次要意圖另記,不要把兩個標籤混成新類別。把相似名稱、同義詞與常見混淆成對列出,讓標注者看得到例子;新標籤須有明確用途與責任人,確認確實需要不同處理後才加入。若兩個標籤導向同一行動,先合併規則或留在次要欄位,避免細到標注者也無從判斷。 定義完成後,請業務與實際接手的人各自標幾則相同訊息,再對照分歧;分歧通常指出定義缺例,而非誰不夠仔細。記下修改前後差異,才知道新規則解決哪一種混淆。標籤說明也要寫明不能僅憑什麼判定:提到退款不代表已符合退款流程,提到登入也未必是帳號權限問題。把相似例子並排,比較造成不同去向的關鍵線索,並用團隊常用詞而非模型術語描述。每次改定義都增加一個正例與一個反例,讓新進人員能照同一標準標注,並讓標籤可直接對應下一步處理。
準備人工標注樣本
樣本先從真實工作流程中挑選,但先移除姓名、電話、訂單號等不必要識別資訊,並依內部資料處理規範決定誰可接觸原文。不要只抽最清楚、最常見的訊息;應同時涵蓋短句、錯字、口語、上下文不足、多重意圖、否定句,以及標籤邊界案例。可按日期或案件批次抽樣,再刻意補入少見但可能造成錯誤派送的例外,並標明是一般抽樣還是補充樣本,避免把補樣比例誤當實際發生比例。 每筆由標注者填寫原始意圖、預期主標籤、次要意圖(若採用)、必要線索、是否可由現有訊息判定,以及不確定原因。先讓兩位熟悉流程的人獨立標一小批,再討論分歧並更新定義;若無法達成共識,就保留「待確認」及原因,不要用多數決把未釐清的規則藏起來。之後由一位標注者整理其餘資料,另一位抽查容易混淆的例子,並記錄標注版本。 把校準用樣本與之後評估規則的保留樣本分開;同一則訊息若反覆用來調門檻,最後只證明系統記得那些例子。每次新增樣本都保留來源批次、標注日期、標籤版本和變更理由,這樣回看錯誤時才能判斷問題來自新情境、標注差異,還是規則改動。樣本中若包含敏感內容,依最小必要原則限制複製、匯出與保存。標注指南可用一頁維護:先看主要目的,再核對必填線索;遇到兩標籤皆合理時,記錄分歧點與待問問題。不要只存標注者答案,也要寫判斷依據,才分得出標籤含糊或資料不足。保留少量未公開答案的案例供之後抽查,避免練習時熟記答案。
制定轉人工條件
轉人工不應只看一個信心分數,還要看錯誤代價、訊息是否完整,以及分類結果會觸發什麼後續動作。先列出「可自動前進」的必要條件,再逐項檢查;任一條件不成立,就暫停自動派送並交給指定角色處理。以下數字只是示意門檻,不代表通用標準,也不代表任何品牌產品的既有能力;應以標注樣本和實際可承接的人工量校準。 | 假設情況 | 路由建議 | 判斷理由 | |---|---|---| |最高分至少 0.80、與次高分差至少 0.15、單一意圖且資料齊全|可自動分類|多項條件同時成立才放行| |最高分低於 0.80,或前兩類差距小於 0.15|交人工確認|可能是模糊邊界| |同時含兩個意圖、缺必要資料,或落在未定義情境|交人工或先補問|分數高也不能消除規則缺口| |涉及高影響決策或輸出格式異常|依預先指定程序停住|風險或系統狀態不能靠分數補救| 門檻要分標籤設定:一般資訊分類可採一組條件,可能造成錯誤承諾、帳務處理或權限變更的類別,則設定更嚴格的人工條件。也要定義無人接手、超出處理時段及人工無法判定時的備援路徑,避免「轉人工」變成沒有負責人的黑洞。開始試行前,先確認每個例外都有接手角色、必要上下文和完成後的回填方式;若人力不足,降低自動放行範圍並監看待處理佇列,不要放寬條件掩蓋積壓。條件需能被人工重現:寫明比較哪兩個候選、必填線索如何核對,以及多標籤輸出怎麼處理。若該類別沒有可校準的標注資料,先預設交人,不用任意分數假裝確定。每次路由留下觸發原因,才可比較不同規則版本造成的人工量變化。
輸出未知與判斷理由
分類結果應能明確表示「無法判定」,不要把最低分分類硬當成答案,也不要只回傳一段含糊的自然語言。每次判斷至少保存候選標籤、未知狀態、觸發規則、理由代碼、必要證據片段、缺少欄位與規則版本;若有信心分數,也記錄其來源和模型版本,避免不同版本的分數被直接當成同一把尺。理由代碼可先用少量固定類型,例如「多重意圖」「缺少指涉」「標籤未涵蓋」「候選差距過小」「格式或來源異常」,再附一句可供接手者理解的說明。 假設訊息只寫「麻煩再處理一下上次那筆」,系統沒有對話上下文可辨識「上次那筆」是什麼,就應輸出未知、理由為缺少指涉,並把原句和缺少的必要資訊交給人補問;不能自行補出訂單、付款或客訴。理由要說明是哪個條件未滿足,而不是宣稱模型「不懂」;這能讓後續把未知分成資料不足、規則缺口或系統異常。 證據片段只保留理解任務所需的最短文字,避免把整段含個資內容複製到多個紀錄。若接手者修正標籤,保留原輸出與修正結果的對照,但不要覆寫原判斷;同時記錄修正人所選理由。這些欄位可存在既有的紀錄或案件流程中,名稱依實際系統決定,文章不假設某個特定介面或工具。最後,讓未知輸出能進入明確佇列,並設定負責人與回填期限,否則「有理由」仍不等於問題已處理。理由代碼不宜一開始就拆得太細;先讓每個代碼對應一種可採取的處理,例如補問、查看前文、請流程負責人新增標籤,或檢查輸入是否截斷。每週整理新增理由,若某類常出現,再決定是否拆分。
記錄錯誤類型分布
把錯誤回看當成可追溯的事件紀錄,而非只記每月總數。每筆至少連起原訊息識別碼、系統原判、人工確認標籤、錯誤類型、觸發條件、規則版本、模型版本、發現日期與處置結果;原文若不必留存,就用受控識別碼連回來源,依資料規範限制存取。類型可先分成標籤定義重疊、必要欄位缺漏、上下文未帶入、多重意圖被壓成單類、門檻不合適、標注者分歧、模型輸出異常等。每一類都要能對應下一步負責人,否則分類再精細也無法採取行動。 彙總時同時看各錯誤類型的件數與分母,例如該期間該標籤的全部受檢件數;只看總件數會把流量大小誤認為品質變化。可依標籤、來源批次、規則版本及人工覆核結果切分,並把「被送交人工但原本可自動判定」與「錯誤自動放行」分開看。前者影響處理負荷,後者可能把工作交錯對象,兩者不該互相抵銷。若同一例子重複出現,要先確認是否同一案件被重送,避免重複計數。 例如,假設本週人工回看 20 筆,其中 6 筆都因「缺少上下文」而無法判定,該類占本週受檢樣本的 30%(6 ÷ 20);這只是示範算式,不是實際營運數據。下一步應查上下文是否根本未傳入,或訊息本身缺少指涉,再決定補資料、調整問句或改分流規則。每次報表附上期間、納入範圍、排除條件和樣本來源,並標記小樣本的限制;若計數口徑改了,要保留舊口徑註記,才不會把定義變動誤判成改善或惡化。回看也要標明覆核是全量或抽樣,否則不同週期的分布無法公平比較。若高風險錯誤只有少數個案,仍應個別處置,不要等到比例變高才反應。
用案例重測規則
每次修規則前,先把人工確認過的錯誤例子改寫成測試案例:保留造成判斷差異的線索,移除不必要個資,附上預期標籤或應轉人工的理由。測試集應同時含已知易混淆例、常見清楚例、資料不足例和新收集的保留樣本;若只重播曾用來調整條件的例子,結果容易過度貼合舊資料。為每個案例記錄它檢查哪條規則,讓失敗時可指出是哪一段判斷需要修正,而不是只看到一個總分。 假設一則訊息同時詢問付款進度與取消訂單,舊規則只看最高分,曾以 0.91 的假設分數自動選「付款」;重測後應驗證多重意圖條件能攔下它並送人工。再用只問付款進度的相似訊息確認,新增條件沒有把清楚案例也一律轉人工。一次只改一種機制,重跑整組案例,逐筆檢查自動分類、未知輸出、理由代碼與路由結果;若任何高影響案例被放行,先停止擴大範圍並修回規則。 驗收前先約定可接受的錯誤類型、人工承接量與回退條件,不用「看起來準」作為標準。每次調整都保存規則版本、變更理由、測試案例及結果;小範圍試行後,再依新錯誤分布安排下一輪回看。你可以先挑一批已去識別的訊息,寫出標籤定義、未知原因和預期去向,作為第一次校準材料。保留舊規則的回歸案例,避免修好多重意圖卻破壞其他標籤。若不符約定條件,撤回變更並查觸發機制;通過後記錄版本與試行範圍,請人工回報新邊界例。若需要把分類、例外派送與人工回看接入既有作業,可先整理樣本與目前交接方式,再到 ZhenheAI 官網 了解 AI/自動化整合的需求釐清、最小化設計、實作與維護。