頁面為何被擋在搜尋外?核對 robots 與 noindex 指示
從 robots.txt、meta robots 與 X-Robots-Tag 逐項核對爬取範圍和 noindex,判斷頁面未出現在搜尋結果是預期設定、設定衝突,還是仍待抓取。
頁面沒有出現在搜尋結果,先別急著加關鍵字或重送網址。先拆成兩件事:搜尋引擎能不能抓到頁面,以及抓到後是否被允許收錄。robots.txt 管理爬取範圍;noindex 表示不要收錄。若 robots.txt 擋住頁面,爬蟲可能看不到頁面上的 noindex,兩個設定就無法照原意搭配。以下從預期清單、實際指示到複查,找出刻意排除、設定衝突或尚未完成抓取的差別。
判讀時也要看目前正式網址實際回應,不要只依賴舊的搜尋快照;同一頁可能因主機、語系或模板不同收到不同指示。把預期與實際輸出逐頁對齊,才能分辨問題在檢索限制,還是頁面已可讀但尚未被收錄。
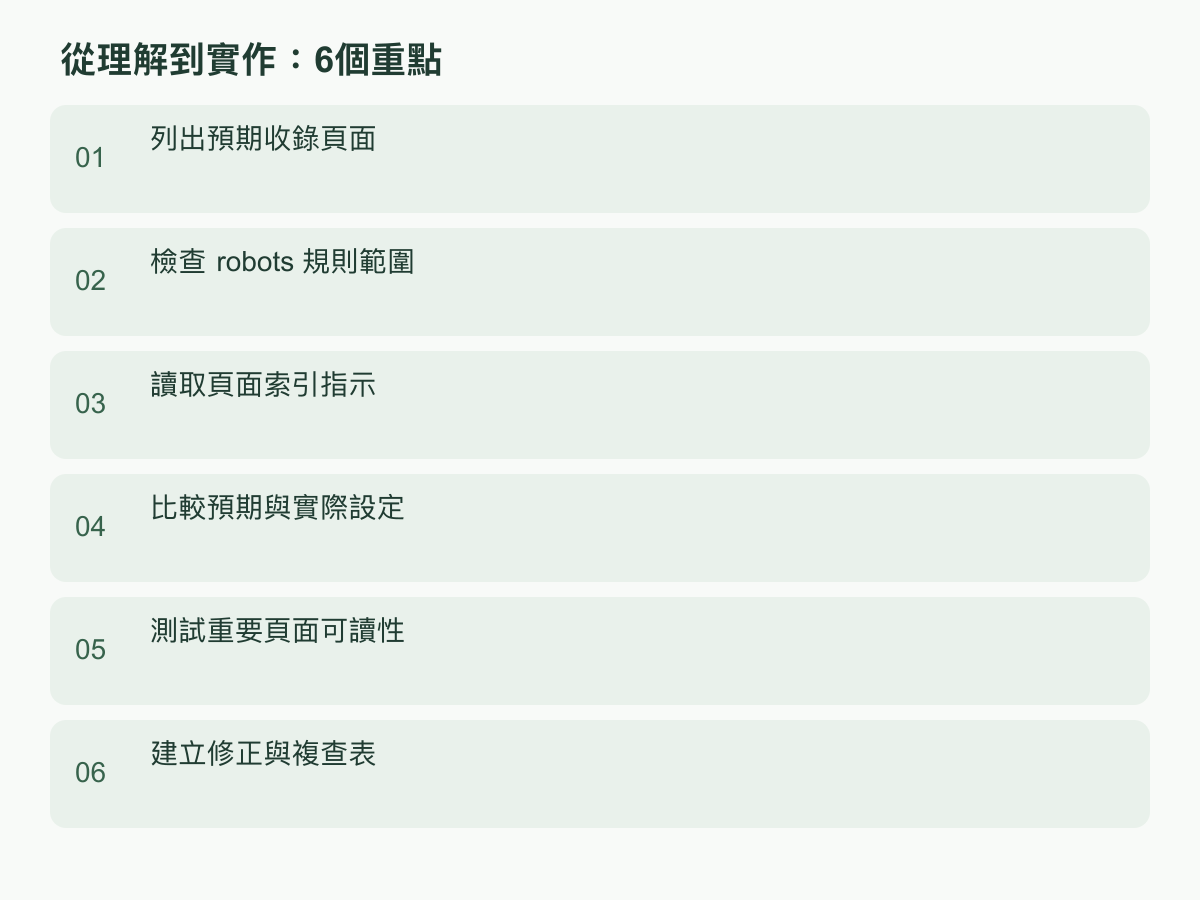
列出預期收錄頁面
先把「希望出現在搜尋結果」寫成逐頁清單,不要用「整個網站要收錄」代替判斷。每列記下完整網址、頁面用途、預期結果、不收錄時的原因、維護人,以及可接受的例外。產品或服務介紹頁、重要分類頁、能獨立回答問題的文章,應逐一確認是否需要被搜尋者找到;登入後台、購物流程、站內搜尋結果、測試頁、帶大量篩選參數的網址,可能有不同安排。這不是固定答案,要看頁面是否對外、是否有獨立價值,以及訪客是否需要從搜尋直接進入。
比對前先統一網址寫法,至少分清 http 與 https、www 與非 www、語系路徑、結尾斜線及追蹤參數。若兩個網址內容相同,記下希望使用的主要版本和其餘版本如何處理;不要把不同網址先混成同一列。記錄「業務想要什麼」後再讀設定,否則既有錯誤容易被誤認為原本就該如此。
例如,同一篇教學可能有正式繁中頁、預覽頁和帶內部篩選的頁面。正式頁預期收錄,預覽頁不收錄,篩選頁要依用途決定;三列分開寫,才能知道哪個規則需要修。頁面若已下架、搬家或只供登入者使用,也記錄原因,因為永久移除、改址與限制存取處理不同。先從最重要的公開頁開始,再延伸到共用模板頁,並預留欄位填入 robots 規則、頁面標籤、回應標頭和最後檢查結果。清單的作用是建立可判斷的目標,不是追求每個網址都進索引。
另將每個網址標成「正式公開」、「刻意排除」或「待確認」,並指定負責人;若團隊沒有權限確認設定,也寫明需要向誰取得。這樣複查時可直接回到原本的目的,不會因搜尋結果一時變動就改錯規則。
檢查 robots 規則範圍
robots.txt 是爬蟲的路徑規則,位置在網站主機根目錄;它限制抓取,不等於頁面不會出現在搜尋結果。先用正式網址的網域查看目前實際提供的 robots.txt,確認檔案讀得到,再看 User-agent 指向哪些爬蟲,以及其下的 Disallow 和 Allow 規則。子網域各自有自己的檔案;測試站的規則不會自動套用到正式站,另一個語系若走不同主機也要分別核對。
接著把清單中的完整路徑逐一對照,而不是只搜尋「noindex」字樣。假設某篇公開教學網址路徑是 /guide/setup/,Disallow: /guide/ 會讓該路徑落在禁止範圍;Disallow: / 則可能擋住整個主機。規則可能指定特定爬蟲,也可能使用較廣的群組,因此要確認哪一組適用,並留意較細的 Allow 規則是否改變結果。用路徑比對工具或人工逐段核對後,把命中的規則及其涵蓋網址記下,避免只看檔案存在就判定正常。
判斷命中時,把 robots.txt 的 User-agent 區塊從標頭到下一個區塊整段讀完,再針對實際爬蟲套用規則;同一條 Disallow 可能只在特定區塊生效,不要跨區塊抽一行解讀。Allow 用來允許較窄路徑時,確認它是否確實涵蓋被封鎖的子路徑;還要核實斜線、資料夾名稱和大小寫是否與正式網址一致。如檔案回應 404、暫時無法取得,或出現在不同主機,也把它當獨立問題記錄,不要拿開發環境檔案推測上線狀態。
若頁面預期收錄卻被擋,先確認是不是共用目錄規則誤傷;若原本就不想讓爬蟲抓取,則確認範圍沒有擴大到公開內容。robots.txt 不支援用 Disallow 宣告 noindex;若目標是不要收錄,還要讓爬蟲能讀到頁面上的索引指示。Google 對 robots.txt 的用途與限制可參考官方說明。
讀取頁面索引指示
確認頁面本身有沒有禁止收錄的訊號。對 HTML 頁面,檢查實際回傳的原始碼中 head 區塊,是否含有 meta name="robots" 或針對 Googlebot 的 noindex;也查看 HTTP 回應標頭是否帶有 X-Robots-Tag: noindex。後一種常用於非 HTML 資源,例如 PDF。不要只看內容管理介面的勾選狀態,因為版型、外掛、伺服器或 CDN 都可能在輸出時加上另一條指示;以訪客和爬蟲取得的正式網址回應為準。
逐項抄下完整值,例如 index、noindex、follow、nofollow,並記錄它來自 HTML 還是標頭。不要把 nofollow 當成 noindex:它控制連結處理,不能單獨證明頁面被排除。若 HTML 寫著允許收錄,但標頭另有 noindex,頁面仍存在禁止訊號;若同一模板套到很多網址,抽查一個預期收錄和一個預期排除頁,看看規則是否依頁型輸出,而非整站共用錯誤值。
也要確認看到的是最終版本:重新導向後的目的網址、登入或錯誤頁、語系切換結果,可能和你原先檢查的網址不同。以停用快取或重新取得頁面後的回應交叉確認,並保留來源片段或標頭紀錄,讓工程人員能定位是哪一層產生指示。Google 說明 noindex 可由 meta 標籤或 HTTP 標頭提供,且被 robots.txt 阻擋時可能無法讀到;可對照官方 noindex 文件。
檢查不只找出 noindex,還要找它由哪個元件輸出。先比較應收錄頁與不收錄頁的原始碼和標頭差異,再查版型條件、內容欄位和伺服器規則;若多個頁型都出現相同訊號,可能是全域設定,若只影響一種模板,追該模板。也檢查不同爬蟲名稱,避免讀到 robots 的值卻漏了 Googlebot 專屬設定。不要因找到 index 字樣就停止檢查,仍需確認是否另有 noindex。再用公開網址確認標籤並非只出現在預覽環境,避免把編輯畫面或快取副本當成正式輸出。
比較預期與實際設定
把第一節的預期,和剛讀到的 robots 路徑、HTML 與 HTTP 標頭放在同一列,比較的是「希望如何」和「爬蟲實際收到什麼」。以下是假設情境,不代表任何特定網站的現況:
| 假設頁面 | 預期 | 實際讀到 | 判斷 |
|---|---|---|---|
| 公開教學頁 | 收錄 | robots 允許;HTML 有 noindex | 指示衝突,查明並移除錯誤 noindex |
| 預覽頁 | 不收錄 | robots 阻擋;沒有 noindex | 不能靠阻擋保證網址不顯示,按隱私需求改用存取限制或可讀取的 noindex |
| 公開 PDF | 收錄 | robots 允許;標頭有 noindex | 到輸出標頭的來源修正 |
可在記錄表中把四種狀態分開:預期收錄且無封鎖,設定符合目標;預期收錄但被 Disallow,先排除路徑規則;預期收錄且可抓但出現 noindex,追標籤或標頭來源;預期不收錄但可抓且沒有 noindex,則目前指示和目標相反。若預期不收錄且同時被阻擋,不代表搜尋系統已讀到排除指示,舊網址可能仍只以網址顯示。每次只改直接造成落差的設定,避免同時更動 robots、meta、標頭和轉址,否則結果改變時難以判斷是哪項修正生效。儲存前確認同一規則是否作用到其他列;儲存後再擷取新回應,才把狀態從待處理改成符合設定。若兩種指示都與目標相符,搜尋未顯示的原因不一定是衝突,應轉到後續抓取與收錄診斷。
判斷前先確認檢查的是同一個網址、同一種爬蟲和同一個回應版本。若目標是公開且要收錄,需能抓取、沒有 noindex,且回應不是錯誤頁;若目標是不收錄但仍公開,應讓爬蟲看得到 noindex,不能同時用 robots 擋住它。若內容必須保密,robots 或 noindex 都不是存取控制,應要求登入或移除公開檔案。當設定與意圖一致,仍未出現在結果中,這表示要另查抓取狀態或收錄判斷,不能把它誤報為 robots 衝突。
測試重要頁面可讀性
先挑首頁、主要產品或服務頁、重要分類頁和能帶來有效訪客的文章,各取正式網址測試,不要只測首頁便假設整站相同。用 Google Search Console 的 URL Inspection 查看 Google 對該網址的已知狀態,再執行即時測試,確認目前是否能連線、是否被 robots 規則阻擋、收到的頁面有沒有 noindex,以及回應內容是否完整。工具結果只能說明檢查當下的可讀性與訊號;測試成功不代表已收錄,也不保證之後一定出現在搜尋結果。
同時用一般未登入瀏覽器開啟頁面,記下最終網址、狀態碼、重新導向、頁面標題和主要內容。如果人看得到正文,但爬蟲只取得空白框架、錯誤提示或登入頁,就要檢查伺服器回應、存取限制和必要資源是否可取得。重要 CSS、JavaScript 或內容 API 若被擋,頁面可能無法呈現預期資訊;逐項比對測試所見畫面與一般訪客看到的畫面,找出缺少的內容或資源,不要先把所有資源都開放或封鎖。
遇到測試結果和原始碼不同,先記錄時間、完整網址和回應,再確認 CDN 快取、登入狀態、地區版本或 A/B 版本是否造成差異。若頁面本來就不應公開,驗證未登入者無法取得內容比檢查 robots 更重要;若是公開頁,則確認所有主要內容可在不執行人工登入或點擊的情況下取得。修正後重新測同一網址,再抽查同模板的第二頁,避免只修到單一頁而漏掉共用輸出問題。Google 的技術條件說明也提醒,可抓取與回應正常只是具備收錄條件,不是收錄保證。
若同頁有分語系或登入狀態,補測主要公開版本,避免只驗到可讀但非目標的網址。把檢查結果存成可重現紀錄。
建立修正與複查表
把每個落差拆成一筆工作,欄位包括網址、原本預期、命中的 robots 規則、HTML 指示、HTTP 標頭、負責人、修正位置、複查日期和證據連結。先依影響排序:重要公開頁被 noindex 或整段路徑遭封鎖,優先處理;本來不公開的頁面若意外允許索引,先確認是否含有敏感資料,再處理存取控制。不要為了讓單一頁通過而整站刪除規則,因為同一條設定可能保護其他頁面或避免大量低價值網址被抓取。
修正前保留目前回應和規則片段,變更後再次取得正式網址的 robots.txt、原始 HTML 和 HTTP 標頭,逐欄確認只有預期項目改變。收錄頁要確認路徑可抓、noindex 已移除;排除頁則確認策略符合目的,並且沒有因放開 robots 就意外公開私人內容。若是共用模板造成,至少回測一頁應收錄和一頁應排除的代表頁,確認模板分流正確。遇到重新導向,再測目的網址,不要把舊網址的結果當成新頁證據。
每一項完成後由負責人按清單重新讀取一次,逐項比對預期值和實際回應;尚未取得權限或證據的項目標為待協助,不要填成已完成。最後把狀態分成「符合預期」、「設定已修、待爬蟲更新」和「仍有衝突」,並附上可重現的讀取結果。若可抓、無 noindex、回應正常而頁面仍未出現,轉查發現、重複內容或收錄判斷,保留已驗證的排除設定,避免反覆亂改。下一步先挑一個重要網址,保存它的 robots.txt 命中結果、HTML 與回應標頭,再依表格完成修正和複測。若你正在整理企業網站、工作流程與 AI/自動化整合方向,可到 ZhenheAI 首頁了解目前定位,並帶著這份網址與證據清單討論下一步。