網頁未被搜尋引擎收錄怎麼查?先分清排除原因與優先順序
逐步判斷頁面是否應收錄、辨識排除原因、檢查網址版本,並建立可回查的修正清單。
發現網址沒有出現在搜尋結果,先不要把所有「未收錄」都當成同一種故障。診斷的第一步,是確認這個頁面是否應該被搜尋引擎收錄,再把報表原因對照到可重現的頁面狀態、網址版本與負責人。以下流程適用於單頁和一批網址:先定義目標、查目前證據、修正控制點,最後回看索引資料是否改變。
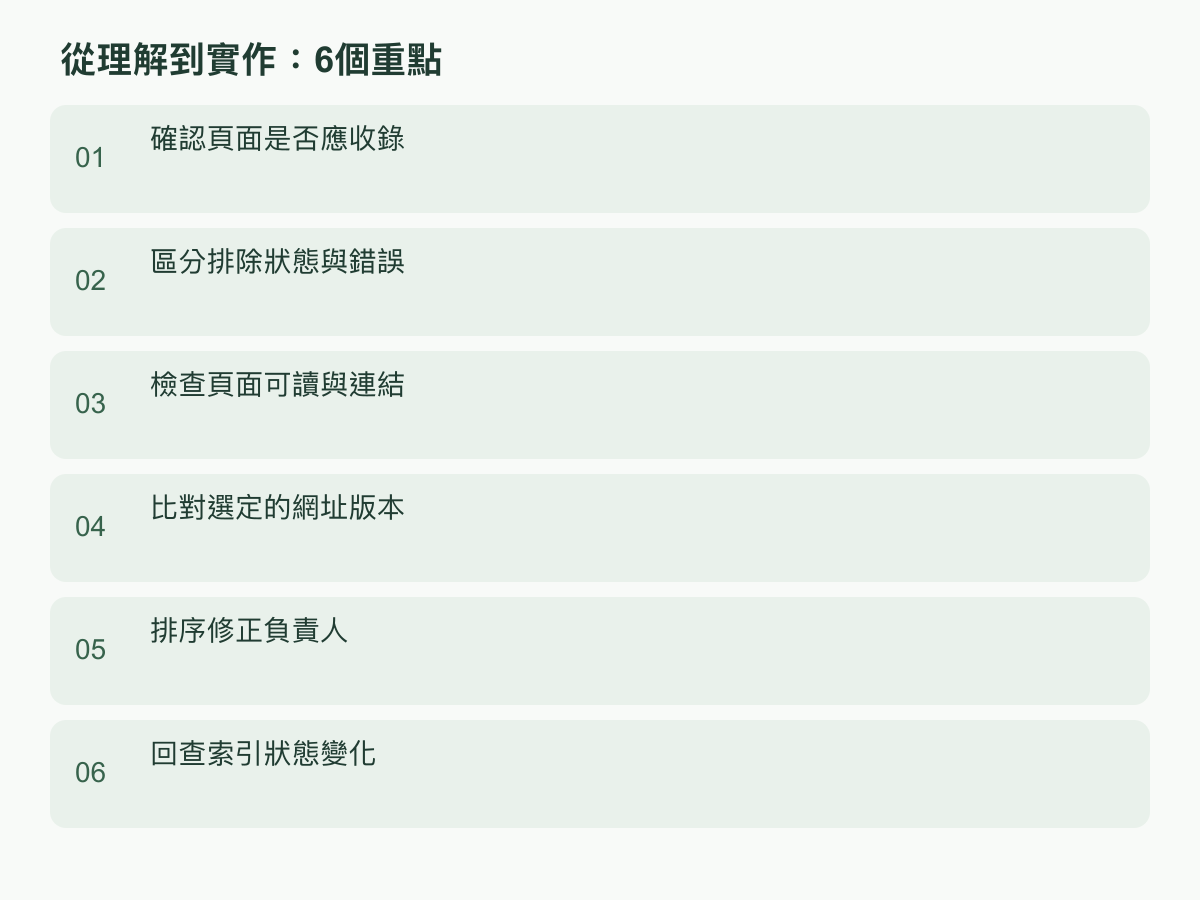
確認頁面是否應收錄
先建立一份「應收錄清單」,不要從報表裡所有未收錄網址直接開工。逐頁問三件事:使用者會不會從搜尋進入這頁?它是否提供其他頁面沒有的主要內容或功能?網站是否希望搜尋者看到它?三題大多是肯定,且網址可公開讀取,才把它列入目標;登入後台、購物車結帳、內部搜尋結果、篩選排序參數頁、測試環境,常常不需要各自成為搜尋結果。
再判斷目前網址是不是頁面的主要版本。若 ?sort=price 只是同一清單排序,或有大小寫、尾斜線、語系副本,要先決定是否需要被分開收錄;不要因它出現在 sitemap,就推論它必須收錄。Sitemap 提供網址線索,內部連結協助發現並呈現站內結構;兩者都不能代替用途判斷或保證收錄。
把答案寫成明確的預期狀態:應收錄的唯一頁、轉址到新頁的舊網址、重複版本、刻意排除頁。例:一篇已公開、內容獨立的服務說明頁可列為目標;相同內容的追蹤參數網址則併入主要網址;會員付款頁則標為不需收錄。這份分類讓報表中的未收錄數字有上下文,不會把每個例外都當成待修缺陷。
若目的或內容價值還說不清楚,先交給頁面負責人決定是否保留、合併或補足內容,而不是急著要求搜尋引擎抓取。站內仍可用但不適合搜尋的網址,也要在清單上註明原因;這可防止改版時移除排除設定,讓內部頁意外成為公開入口。若有多個近似頁,先選一個主要版本,再決定其餘保留、整併或轉址。完成清單後,為每個目標 URL 記錄語系、主要網址、頁面用途與判定理由;後續看到未收錄狀態,才能分辨政策設定錯誤、網址重複,還是本來就不該出現。
區分排除狀態與錯誤
報表狀態要按機制分組。第一類是刻意排除:已下架、無替代頁的 404、非搜尋入口頁或經確認不需獨立出現的重複版本;這些未收錄可能是正確結果。第二類是可抓取但未收錄:搜尋引擎已發現或爬取頁面,卻尚未選擇索引;先核對是否新頁、內容是否足以獨立滿足需求、內部連結是否清楚,再觀察其後續變化。這類狀態不等於伺服器故障,也不能只靠重新送出要求解決。可參考官方索引報表說明。
第三類是技術阻擋或錯誤,例如意外的 noindex、robots.txt 封鎖、伺服器回應錯誤、轉址循環,或頁面只對登入者可讀。這些需找出設定來源;尤其 robots.txt 封鎖會令爬蟲看不到頁面中的 noindex,兩者不是可互換的控制。第四類是版本選擇:某頁被判定與另一網址重複,搜尋引擎選擇了不同 canonical。若那個版本符合原先目標,通常處理方式不是硬把副本救回索引。
把每筆原因翻成一個可驗證問題:「是哪個回應、標籤、轉址或網址關係造成這個狀態?」例如報表顯示已抓取但未收錄,可開頁檢查主內容、回應碼與同站相似頁,不能直接歸咎 robots.txt。若原因是 5xx,就從主機紀錄和頁面回應確認是否仍重現;若只在舊資料出現,先比對最後抓取時間與現況,再決定是否修正。
可以把行動分成「確定錯誤、狀態合理、證據不足」三欄。確定錯誤才建立修復工作;合理排除記下預期理由,避免反覆返工;證據不足則補一次頁面檢查或向網站負責人確認。如此能避免把整個未收錄清單當成同一個故障,也能把高影響錯誤與正常的排除狀態分開。已索引但不該出現的網址,也要列為政策問題,不能把數量增加當成果。
檢查頁面可讀與連結
檢查頁面可讀時,從一般訪客與爬蟲可能遇到的入口開始,不要只看編輯器預覽。以未登入視窗打開目標 URL,確認沒有跳到登入頁、空白模板、錯誤頁或不相關網址;再檢查伺服器實際回應是否穩定、是否連續轉址,以及主要內容是否在載入後出現。若回應時有時無,保留發生時間、URL、狀態碼與可重現步驟,交給主機或開發負責人查,而不是先重送索引請求。
接著分開核對抓取與索引控制。robots.txt 的規則決定爬蟲可否抓取路徑;頁面的 noindex 標籤或 HTTP 標頭則表示不要放進索引。逐一查看頁面原始輸出和回應標頭,確認規則套用在目標 URL、不是只看網站首頁或 CMS 編輯畫面。若頁面被 robots 封鎖,搜尋引擎可能讀不到頁面上的 noindex,因此不能以「有 noindex 所以安全」取代實際的存取設定。相關限制見noindex 官方說明。
再看內容是否可理解、可到達。頁面要有明確主體與可讀文字;主要內容若依賴腳本載入,至少檢查瀏覽器與網址檢查工具看到的呈現是否一致。從首頁、分類頁或相關內容頁加入可見的內部連結,讓訪客與爬蟲都能沿著正常路徑到達;更新 sitemap 時只放希望收錄的主要 URL。孤立頁即使技術上可開啟,也較難從網站結構判斷重要性。
每次只記錄能改變結論的證據:回應碼、是否轉址、抓取允許、索引允許、主內容是否呈現、有哪些內部入口。舉例,若瀏覽器正常而搜尋工具讀到 500,就記錄兩邊時間與輸出並查快取或伺服器差異;若兩邊都讀到頁面但索引被禁止,則回到 CMS 模板或標頭設定找來源。證據與機制對得上,才算找出可修正原因。若多頁同時出現相同狀況,先查共用模板或 CDN 規則;單頁異常再沿該 URL 追查。
比對選定的網址版本
同一內容可能有多個看似有效的 URL:HTTP 與 HTTPS、帶或不帶 www、尾斜線、有無大小寫、追蹤參數、篩選參數,或不同語系路徑。先以使用者實際應分享與搜尋的版本作為目標,再逐個檢查其他版本如何處理。若內容本來相同,通常要讓副本轉址或以 canonical 指向選定版本,並讓內部連結、sitemap、導覽和頁面中的 canonical 一致;不要把一個版本放進 sitemap,卻在所有內鏈都送往另一個版本。
在網址檢查工具中分辨「網站宣告的 canonical」和「搜尋引擎選定的 canonical」。前者是網站偏好訊號,後者是索引資料呈現的選擇;兩者不一致時,先比較內容相似度、轉址、內部連結和 sitemap,而不是把報表數字視為設定一定生效。即時測試能查看目前頁面是否可被讀取,不能替代索引資料判斷,也不能預測搜尋引擎最後會選哪個版本。
逐一檢查有代表性的 URL:開啟目標頁、追蹤每次轉址、確認最後落點,再檢視原始 HTML 的 canonical。舉例,若 https://example.tw/article?utm_source=newsletter 只是帶追蹤參數的副本,預期應落回不帶參數的文章網址;若語系內容不同,就不應只因路徑相似便全部指向同一語言頁。這是示意網址,實際做法應依內容是否相同決定。
最後比較兩份清單:網站想保留的主要網址,以及搜尋引擎目前選中的網址。每個不一致都標成「設定不一致」「內容重複待判斷」或「預期版本不同」;先修共用模板和導覽等一對多來源,再處理單一 URL。只在重複副本上反覆請求索引,既不會改變主網址設定,也會讓負責人失去清楚的驗收點。不要只比 canonical 標籤;轉址終點、語系路徑與 sitemap 也要一致。修改共用設定後,再抽查不同模板的樣本,確認不是只有一篇文章被手動修補。
排序修正負責人
建立處理清單時,按「影響哪些目標頁、原因是否確定、能否一次修好多頁」排序,不按報表列出先後處理。先修預期應收錄且阻擋明確的頁面,再處理影響多頁的共用模板或路由,最後檢視尚無技術錯誤但未被選入索引的內容。每項工作寫出一位負責人、證據、預期結果和回查方式;SEO 負責人負責分類驗收,開發或平台負責改狀態碼與模板,內容負責人決定合併、補充或保留頁面。沒有負責人與完成條件的「再請 Google 收錄」不是可執行任務。
清單欄位可固定為:目標 URL、應有狀態、觀察到的原因、證據位置、負責人、修正項、驗收結果、回查日。一次只給一個最終負責人,其他人列協作者;若原因尚未確認,派給能取得對應資料的人先補證據,不先指派「修復」。這樣開發不必替內容價值猜決策,內容也不會自行改伺服器規則。
以下是純假設的 20 個目標頁盤點:
| 狀況(假設) | 數量 | 負責人與下一步 |
|---|---|---|
| 頁面回應 5xx | 4 | 開發:查主機與錯誤紀錄,確認回應穩定 |
| 誤套 noindex | 3 | CMS:移除錯誤設定,確認公開頁可索引 |
| 參數副本指向不一致 | 5 | 開發+SEO:統一主要網址與內鏈 |
| 新頁尚無足夠入口 | 8 | 內容:補相關內鏈並記錄下次檢查 |
這個假設例子合計 4+3+5+8=20。排序時先確認 4 個 5xx 和 3 個誤套設定是否確實影響應收錄頁,再由開發修正共用錯誤來源;5 個參數副本可由同一組 URL 規則處理。最後看 8 個新頁是否都應收錄,再決定補連結或調整內容。若其中某頁原本不應收錄,就先更正清單,不為了降低未收錄數而補工。
對跨部門項目,把單一修復責任交給能修改該層的人,SEO 負責人維持 URL 清單和驗收,避免多人同時改 canonical 或重複送出要求。
回查索引狀態變化
修正完成後,先做技術回查,再看索引狀態是否更新。第一輪用未登入瀏覽確認 URL、回應碼、轉址終點與主要內容;第二輪查看頁面目前是否允許抓取與索引、canonical 是否符合預期;有修正時可做即時測試,確認目前版本已能被讀取。不要把即時測試通過當成已收錄,因為它只反映當下可抓取性,索引資料仍可能是之前的版本。
接著建立可比較的紀錄:URL、原排除原因、修正內容、網站端驗收結果、目前索引資料、搜尋引擎最後抓取時間與下次檢查條件。比對同一個 URL 與同一個狀態來源,否則可能把版本差異或報表更新延遲誤認成改善。若報表已換成新原因,先回到新原因,不要沿用舊任務;若仍是相同原因,確認修正是否上到正式頁、是否被快取覆蓋,再決定是否升級給網站負責人。
索引請求只適合已修正、確實重要且目前可抓取的網址;請求代表提交檢查線索,不是優先處理承諾或收錄保證。不要為大量參數副本重複送件,先修路由、canonical、內鏈或 sitemap 等共同來源,再依重要性挑代表頁觀察。對內容本來就不需收錄的網址,不要為了讓圖表變綠而改掉正確的排除設定。
把狀態變化也納入完成條件,例如「5xx 已消失,頁面可讀,等待索引資料刷新」,或「重複副本仍未收錄,但已選到預期主要網址,因此按預期結案」。前者尚未證明已收錄,後者雖仍顯示未收錄,卻可能符合目標。修正前後都保留一份狀態快照,才看得出變化來自哪項處理。現在先挑一個最重要的應收錄 URL,完成狀態、頁面版本與負責人三項記錄,再從 ZhenheAI 首頁 了解品牌目前的網站與工作流程內容。